
들어가며 🔎
안녕하세요! 저는 에이피알 개발1팀에서 DevOps 엔지니어로 일하고 있는 유성룡이라고 합니다. 👋
2026년, 저희는 서비스 간 통신의 보안성과 관측 가능성을 높이기 위해 Istio Ambient를 도입했습니다. 공식 벤치마크와 프록시 배치 구조를 비교해 보니, Sidecar보다 리소스 부담을 줄일 수 있다고 판단했기 때문인데요.
그런데 막상 운영 환경에 배포하자, 영상 콘텐츠가 있는 서비스에서 504 장애가 발생했습니다. 처음에는 흔히 보던 클라이언트 연결 종료(DC)처럼 보였어요. 그런데 지표를 따라가 보니, 원인은 Istio Gateway 안에서 Envoy가 half-close를 처리하는 방식에 있다는 것을 발견했습니다.
이 글에서는 이런 504 장애를 어떤 지표로 좁혀 갔는지, 그리고 Envoy 안에서 무슨 일이 벌어졌는지를 중심으로 이야기해보려 합니다. 그 전에 Ambient를 고른 배경을 짧게 짚고, 마지막에는 근본 수정 전까지 적용한 우회 방법과 도입 이후 달라진 운영 방식도 소개할게요.
왜 Istio를 도입하게 되었을까요?
회사가 고속 성장하면서 개발팀이 관리하는 서비스도 빠르게 늘었어요. 서비스가 많아질수록 서비스 간 통신을 안전하게 관리하고, 문제가 생겼을 때 어디에서 무슨 일이 일어났는지 빠르게 확인할 수 있는 환경이 필요해졌죠. 다만 서비스가 늘어나는 만큼 인프라 비용도 함께 늘고 있었기 때문에, 비용 부담이 적은 방식이어야 했어요.
Istio는 Service Mesh를 대표하는 플랫폼이에요. Service Mesh는 MSA(Microservice Architecture) 환경에서 서비스가 계속 늘어나더라도 서비스 간 연결을 효율적으로 관찰하고 제어할 수 있게 도와주는 계층입니다.
저희가 Istio 도입을 검토하면서 기대한 효과는 크게 세 가지였어요.
mTLS를 통한 서비스 간 통신 보안 강화
트래픽 제어를 통한 서비스 안정성 향상
서비스 간 통신에 대한 관측 가능성 향상
그런데 막상 도입하려고 보니 고민이 하나 생겼어요. 오랫동안 쓰이며 안정성이 검증된 Sidecar 방식을 고를지, 상대적으로 비용 효율적인 Ambient 방식을 고를지 정해야 했거든요. 🤔
Sidecar와 Ambient, 무엇이 다를까요?
두 방식 모두 Service Mesh의 주요 기능을 제공하지만, 프록시를 배치하는 방식이 달라요.
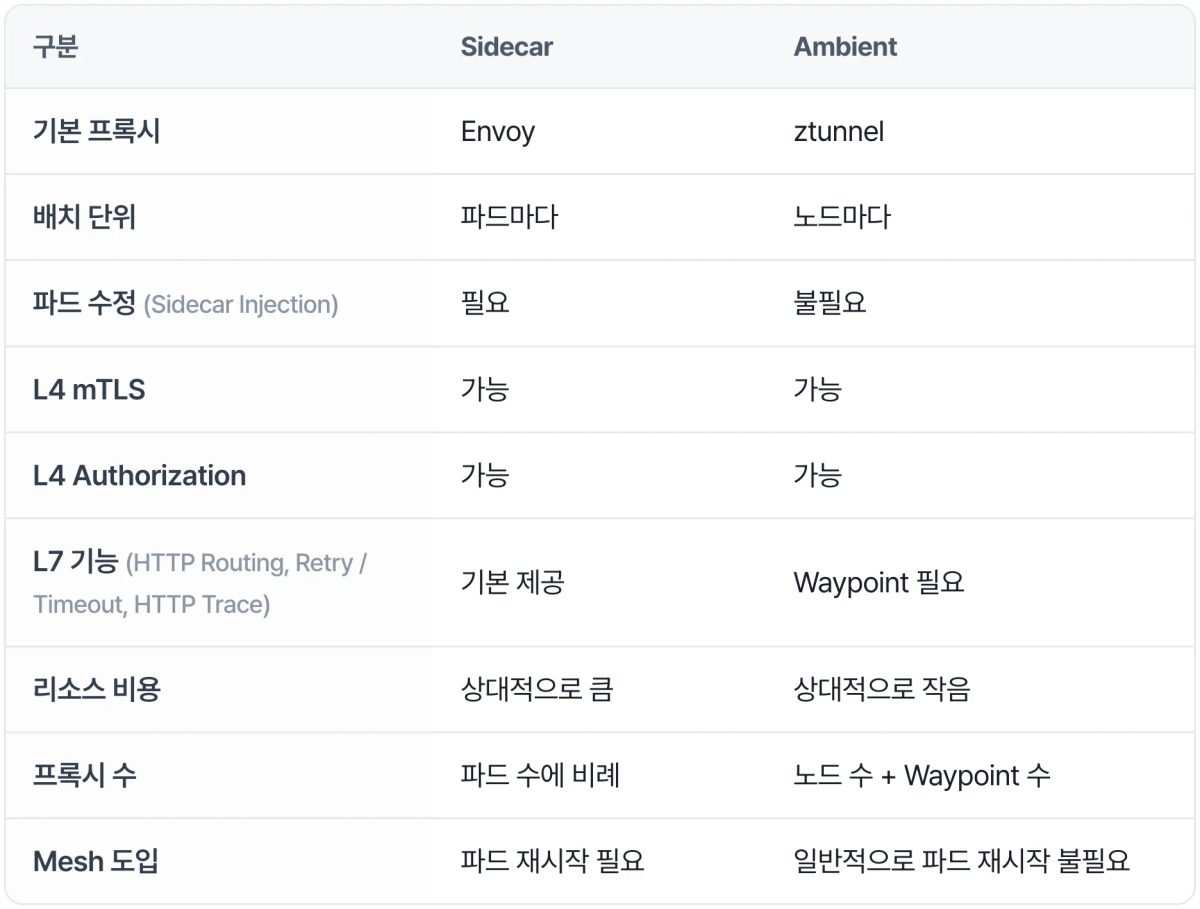
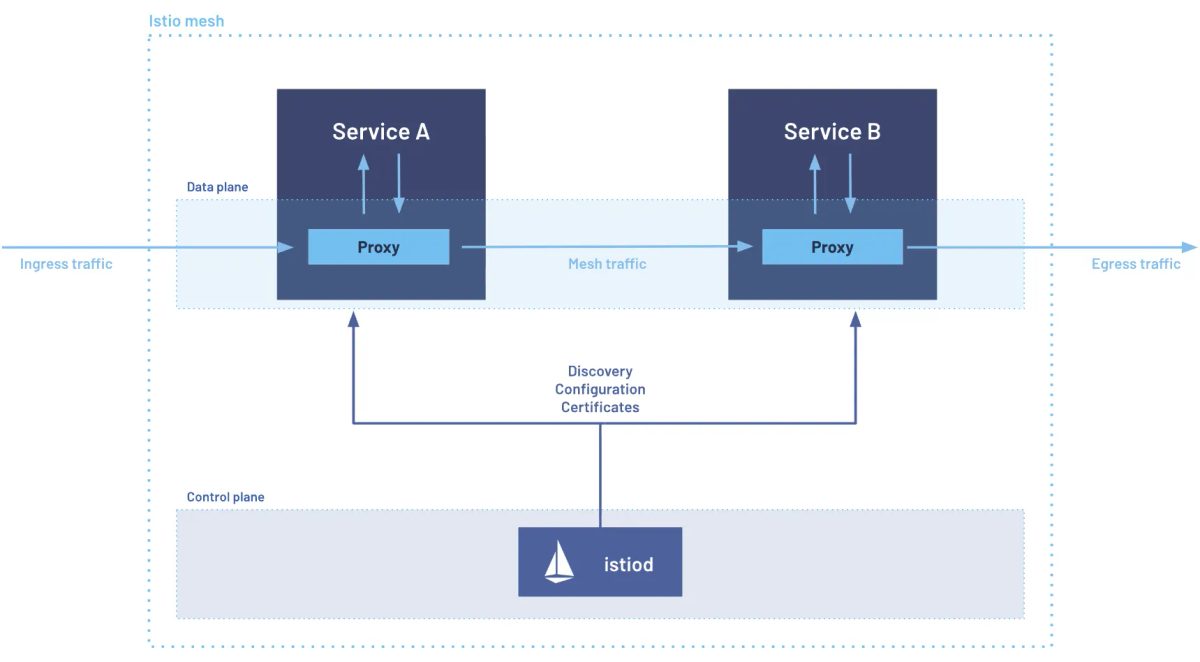
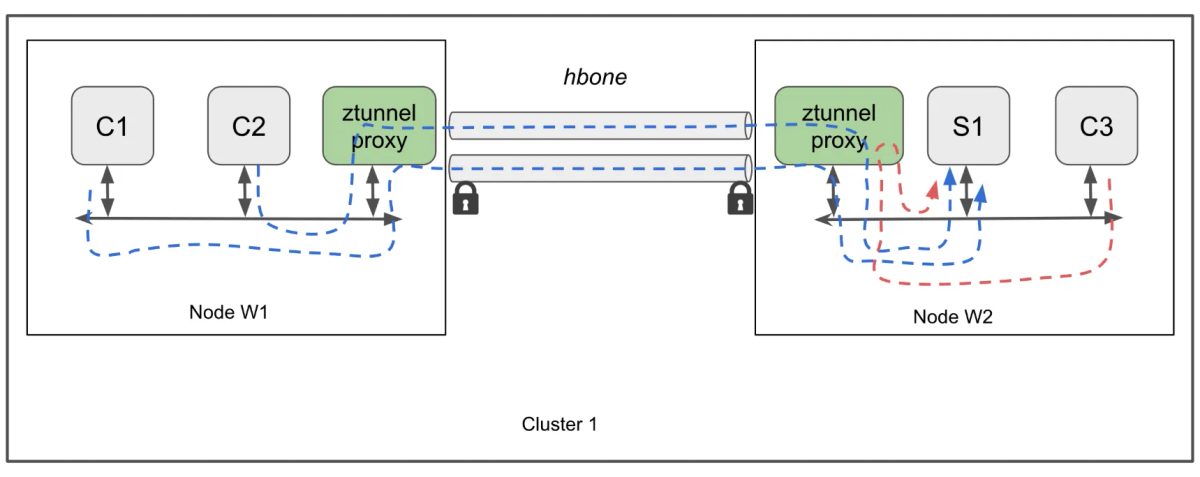
Waypoint까지 함께 쓰면 기능 면에서는 두 방식에 큰 차이가 없는데요. 가장 눈에 띄는 차이는 '비용'이었습니다.
Sidecar 모드에서는 모든 파드에 프록시 컨테이너가 추가돼요. 반면 Ambient 모드는 노드 단위의 ztunnel을 기본으로 쓰고, L7 기능이 필요한 서비스에만 Waypoint를 추가합니다.
모든 서비스에 같은 수준의 기능을 강제로 적용하는 대신, 필요한 서비스에 필요한 만큼만 리소스를 쓰는 방식이라고 볼 수 있어요.
비용은 얼마나 달랐을까요?
Istio 공식 문서에는 Istio 1.24에서 1KB 크기의 요청을 초당 1,000건(1,000 RPS) 처리할 때 프록시 하나가 쓰는 리소스가 나와 있습니다.
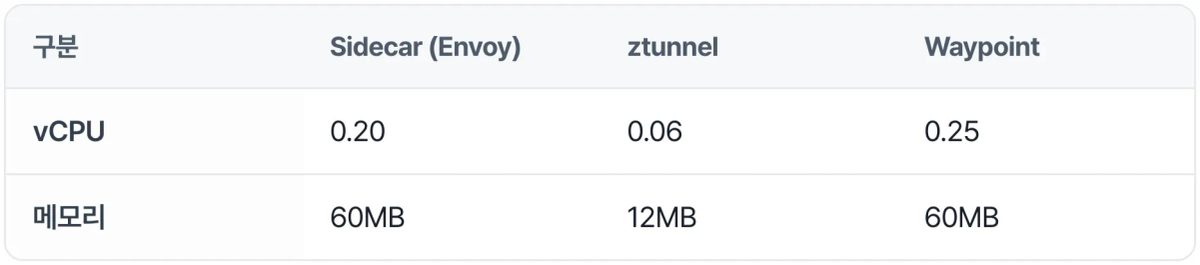
여기서 주의할 점이 하나 있어요. 이 수치는 파드나 노드 하나당 고정 비용이 아니라, 프록시를 지나가는 트래픽 1,000 RPS당 사용량이에요. 그래서 두 방식을 비교할 때는 같은 트래픽을 기준으로 놓아야 정확합니다.
같은 트래픽을 처리할 때 ztunnel은 Sidecar보다 CPU를 약 70%, 메모리를 약 80% 적게 써요.
L7 기능이 필요한 서비스에만 Waypoint를 붙이면 되니, 모든 파드가 Envoy를 하나씩 들고 있는 Sidecar보다 전체 사용량이 작죠.
실제 운영 환경에서는 차이가 더 커져요. Sidecar는 트래픽이 거의 없는 파드에도 붙고, Istio 1.30.0 Helm 차트(istio-discovery)의 기본값(global.proxy.resources)은 프록시 컨테이너마다 CPU 100m, 메모리 128Mi를 requests로 예약해요. 예를 들어 파드가 2,000개라면 트래픽과 상관없이 CPU 200 vCPU, 메모리 약 270GB를 예약해 두는 셈이에요.
반면 ztunnel은 노드마다 하나만 떠 있어요. 실제로 저희 클러스터의 ztunnel은 노드당 약 8~20MB의 메모리만 쓰고 있습니다. 노드에 파드가 많이 배치될수록 고정 비용 부담은 더 줄어들고요.
저희는 Service Mesh의 보안성과 관측 가능성을 확보하면서도, L7 기능이 필요 없는 서비스에 리소스를 낭비하지 않는 방향을 택했어요. 이것이 최종적으로 Istio Ambient 모드를 도입하게 된 이유라고 할 수 있습니다.
도입 과정에서 만난 문제
물론 도입이 순조롭기만 했던 건 아니에요. 운영 환경에 적용한 뒤 예상하지 못한 문제를 만났습니다. 😅
영상 콘텐츠가 있는 서비스에서 504가 발생하다
테스트 환경에 Istio를 적용했을 때도 DC(Downstream Connection Termination) 로그는 보였어요. ALB의 keep-alive 종료나 사용자의 요청 취소로 생기는 DC는 대부분 장애로 이어지지 않아요. 테스트 환경에서도 클라이언트에 영향을 주는 DC는 확인되지 않았고요. 그래서 운영 환경에 배포를 진행했어요.
그런데 배포 후 A 서비스에서 클라이언트가 접근할 때 504 에러가 발생했어요. 서버에는 수 ms 차이로 DC 에러가 기록됐고요.
특이한 점도 있었어요. 인프라 환경, 새로 도입한 Istio Ambient, 개발 언어까지 서비스 구성이 거의 같은 B 서비스에서는 같은 장애가 발생하지 않았어요. 두 서비스의 차이는 A 서비스에 영상 콘텐츠가 있다는 점이었어요.
아래는 504 에러에 대응되는 Gateway access log의 예시예요.
[2026-05-20T06:20:33Z] "GET /en/gov.html HTTP/1.1" 0 DC downstream_remote_disconnect - "-" 0 0 60001 -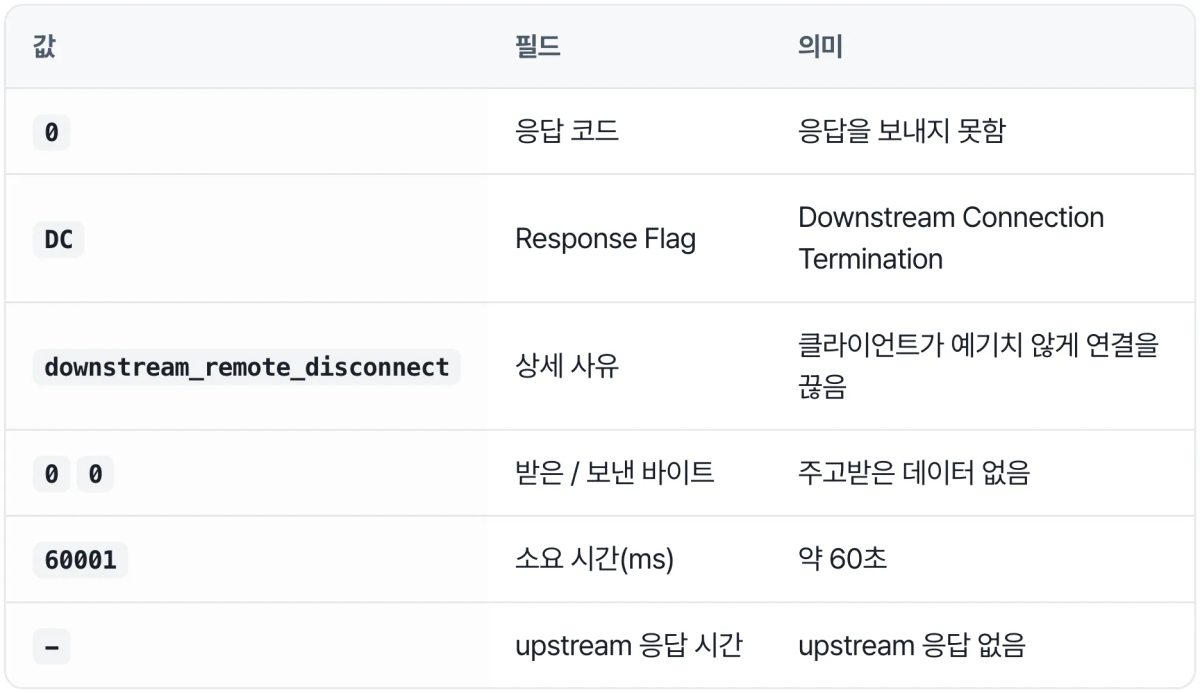
ALB를 통해 Istio Gateway로 요청이 들어왔지만 60초 동안 응답이 없었어요. 결국 ALB idle timeout(기본 60초)에 걸려 사용자에게 504가 반환된 상황이었어요.
지표를 따라가며 원인을 좁혀 가다
결정적인 단서는 Istio Gateway의 Envoy(istio-proxy)에서 확인한 connect_originate 클러스터 지표였어요. connect_originate는 Gateway가 HBONE으로 각 파드에 연결할 때 쓰는 클러스터예요.
현재 처리 중인 요청 수를 뜻하는 rq_active가 시간이 지나도 줄어들지 않았어요. 들어온 요청 수인 rq_total과 rq_active는 계속 늘어나는데, rq_success, rq_error, rq_timeout은 더 이상 늘지 않았어요.
요청은 들어오는데 성공도, 실패도, 타임아웃도 아닌 상태였어요. 말 그대로 요청이 중간에 멈춰 있었던 거예요.
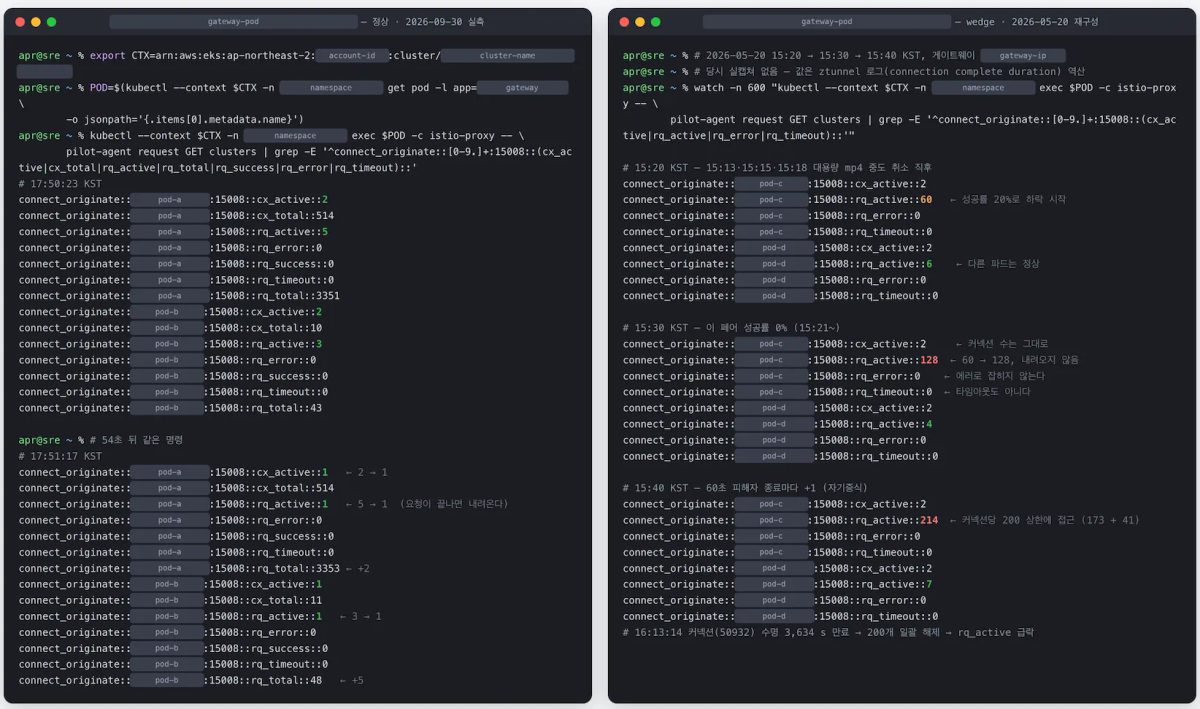
같은 증상이 Istio GitHub 이슈에도 보고돼 있었어요. 이 이슈 역시 영상을 보다가 다른 구간으로 넘길 때, 즉 Range 요청이 중간에 끊길 때 발생했어요. Envoy 지표 추이도 저희와 거의 같았고, rq_active가 줄지 않는 시점부터 영상 재생이 멈추는 현상도 같았어요.
원인은 Envoy 내부에서 half-close가 제대로 처리되지 않아 스트림이 새는 문제였어요.
half-close는 송신과 수신의 종료를 따로 처리하는 방식이에요. 예를 들어 클라이언트가 더 이상 데이터를 보내지 않더라도, 서버가 보내는 응답은 계속 받을 수 있도록 연결을 유지하는 개념이에요.
왜 영상 콘텐츠에서 문제가 더 쉽게 나타났을까요?
문제의 핵심 조건은 응답이 진행 중일 때 클라이언트가 연결을 끊는 것이었어요. 영상은 응답이 크고 길어서, 사용자가 보다가 페이지를 닫거나 다른 구간으로 넘기면 이 조건이 쉽게 만들어져요.
사용자가 취소해서 생긴 첫 DC 자체는 장애가 아닐 수 있어요. 하지만 이 연결이 완전히 정리되지 않고 남으면, 그 뒤에 들어오는 다른 사용자의 요청이 504와 함께 실제 장애로 이어질 수 있어요.
먼저 알아 둘 구조가 하나 있어요. Istio Gateway 안에는 HTTP 요청을 다루는 HCM(HTTP Connection Manager)과, 요청을 HBONE 터널에 실어 보내는 tcp_proxy가 내부 연결로 이어져 있어요. 아래 그림의 '좀비 스트림'은 연결이 끊긴 뒤에도 정리되지 않고 남은 스트림을 저희 팀에서 부르던 이름이에요. 관련 이슈에서는 stream leak이라고 불러요.
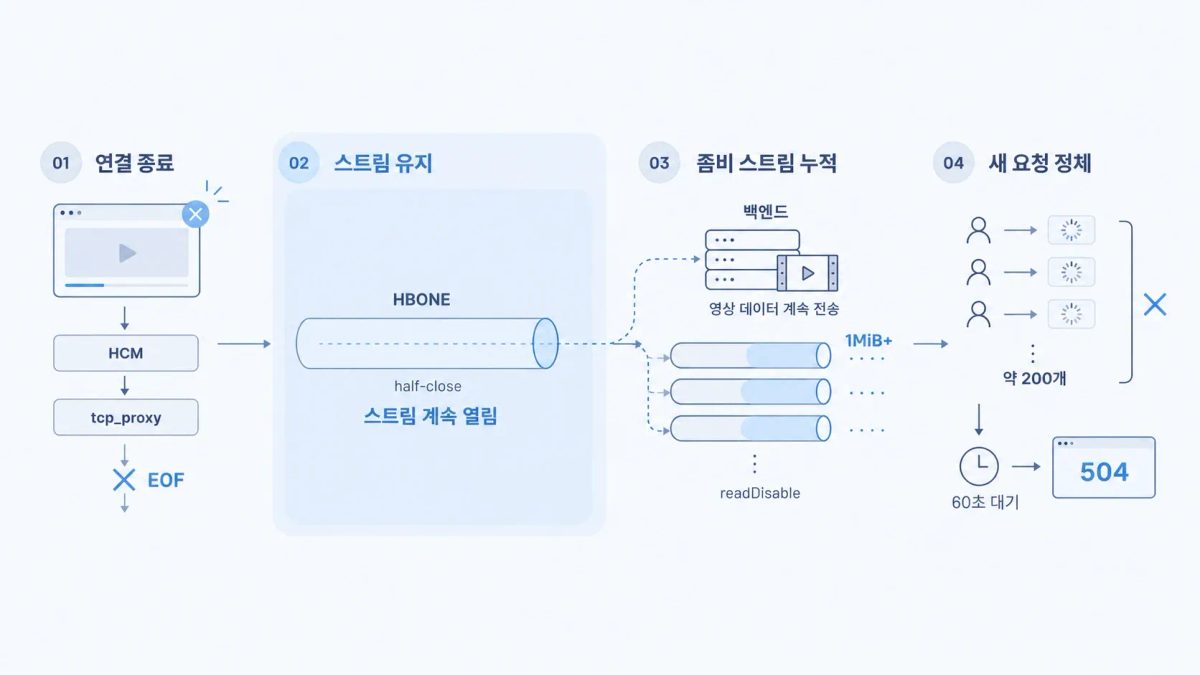
사용자가 영상을 보다가 페이지를 닫으면, 응답 도중에 클라이언트 연결이 끊겨요.
Gateway의 HCM은 요청을 끝내고 tcp_proxy와 이어진 내부 연결을 닫아요.
그런데 tcp_proxy는 이 종료를 "완전히 끊김(RemoteClose)"이 아니라 "상대가 보낼 데이터가 끝남(EOF)"으로만 받아요.
half-close가 켜져 있으니 tcp_proxy는 응답은 아직 받는 중이라고 보고 HBONE 스트림을 계속 열어 둬요.
여기까지는 Envoy 수정 PR에서 설명하는 내용이에요. 그 뒤 장애로 번진 과정은 저희가 관측한 지표를 바탕으로 이렇게 추정했어요.
백엔드는 영상 데이터를 계속 보내요. Envoy는 버퍼가 연결별 한도(기본 1MiB, 약 1MB)를 넘으면 상대편에서 데이터를 읽지 않도록 멈추는(readDisable) 흐름 제어를 해요. 저희는 이 흐름 제어와 HTTP/2 전송 한도(window)가 함께 걸리면서, 스트림이 정리되지 않은 채 자원을 붙잡고 있었다고 봤어요.
문제가 된 파드로 가는 요청은 성공률이 0%까지 떨어졌지만, 같은 시각 다른 파드는 정상이었어요. 그래서 정리되지 않은 스트림이 쌓이면서 같은 HBONE 연결을 쓰는 새 요청까지 영향을 받은 것으로 판단했어요. 참고로 목적지 ztunnel은 HBONE 연결 하나당 동시 스트림을 최대 200개까지 받아요.
재구성한 지표를 보면
rq_active는 ALB가 60초 만에 요청을 끊을 때마다 하나씩 늘었어요. 504로 끝난 요청도 정리되지 않은 스트림으로 남으면서 문제가 스스로 커진 것으로 보여요.
이 스트림들은 약 1시간 뒤 연결 수명이 끝나고 나서야 한꺼번에 정리됐어요. 수정 PR에서 설명하는 동작(idle timeout까지 스트림이 남는 현상)과도 맞아요.
정리하면, HCM은 소켓을 닫았지만 tcp_proxy는 연결이 닫힌 걸 알지 못한 채 half-close 상태로 스트림을 유지한 것이 문제의 핵심이었어요.
관련 이슈와 수정 방향
이 문제는 Envoy의 half-close 스트림 누수 수정 PR에서 다뤄졌어요. 수정 방향은 peer가 완전히 종료된 것을 인지하면 남은 데이터를 먼저 처리한 뒤, reset으로 HBONE CONNECT 스트림을 닫는 방식이에요.
두 PR은 2026년 9월 Envoy에 머지됐어요. Istio에는 1.32 버전부터 반영될 예정이고, 1.29~1.31 버전으로는 백포트할 계획이 없다고 해요. 이후 메인테이너가 수정 버전에서 끊긴 스트림이 바로 정리되는 것을 확인하면서 이슈도 닫혔어요.
그래서 어떻게 대응했을까요?
장애 당시에는 수정 사항이 아직 Istio에 반영되지 않은 상태였어요. 그래서 근본 수정 전까지 장애를 막을 방법부터 찾았어요.
먼저 짚고 넘어갈 점이 있어요. A 서비스의 영상은 CDN이 아니라 애플리케이션이 직접 제공하고 있었어요. 영상 수가 많지 않아 페이지와 함께 정적 파일로 배포했고, 트래픽도 크지 않아 따로 분리할 필요를 느끼지 못했거든요. 그래서 영상 요청도 다른 요청처럼 ALB와 Istio Gateway를 거쳐 애플리케이션까지 들어오고 있었어요.
이 구조가 이번 버그와 만나면서 문제가 됐어요. 장애를 일으키는 요청 대부분이 영상이었기 때문에, 영상 콘텐츠를 CDN으로 분리하기로 했어요.
영상이라고 해서 모두 용량이 큰 것은 아니지만, 응답이 클수록 버퍼 한도를 넘기기 쉬워요. 그래서 1MB 이상인 콘텐츠는 CDN에서 직접 제공하도록 바꿨어요. 1MB라는 기준은 앞에서 본 Envoy 버퍼 한도와 같은 값이에요.
그 결과 영상 요청이 더 이상 Istio Gateway를 거치지 않게 됐고, 같은 장애도 다시 발생하지 않았어요.
다만 CDN 분리로 버그 자체가 사라진 건 아니에요. 이 버그는 영상만의 문제가 아니라, 응답 도중 연결이 끊길 수 있는 큰 응답이라면 파일 다운로드처럼 어디서든 생길 수 있어요. 근본적인 해결은 수정이 담긴 Istio 1.32 이후 버전으로 올리는 거예요.
그렇다면 Istio를 업그레이드한 뒤에는 영상을 다시 애플리케이션에서 제공하게 될까요? 저희는 CDN을 계속 유지하기로 했어요. 영상처럼 큰 정적 콘텐츠는 처음부터 CDN이 더 잘 맞는 자리예요. 사용자와 가까운 곳에서 캐시해 응답이 빠르고, 애플리케이션과 Gateway는 큰 파일을 전송하는 데 자원을 쓰지 않아도 되거든요. 결과적으로 이번 장애는 정적 콘텐츠를 어디에서 제공해야 하는지 다시 돌아보는 계기가 됐어요.
도입 후 달라진 점
문제를 해결하는 과정은 쉽지 않았지만, Istio Ambient를 도입하면서 분명히 얻은 것도 많았어요. 🙌
허용된 워크로드만 통신하도록 만들다
mTLS와 L4 Authorization Policy를 적용해, 허용된 워크로드 사이에서만 통신할 수 있도록 구성했어요.
서비스 간 통신을 기본적으로 보호하면서, 공격 표면과 장애가 퍼질 수 있는 범위(blast radius)를 줄일 수 있었어요.
트래픽을 더 안정적으로 전달하다
DestinationRule의 warm-up 설정으로, 기존 ALB의 느린 시작 모드(slow start mode)와 비슷한 기능을 Istio에서도 구현할 수 있었어요.
새로 추가된 인스턴스에 트래픽을 한꺼번에 보내지 않고, 설정한 시간 동안 조금씩 늘려 보내요. 이 설정은 Istio Gateway(또는 Waypoint)를 거치는 트래픽에 적용돼요.
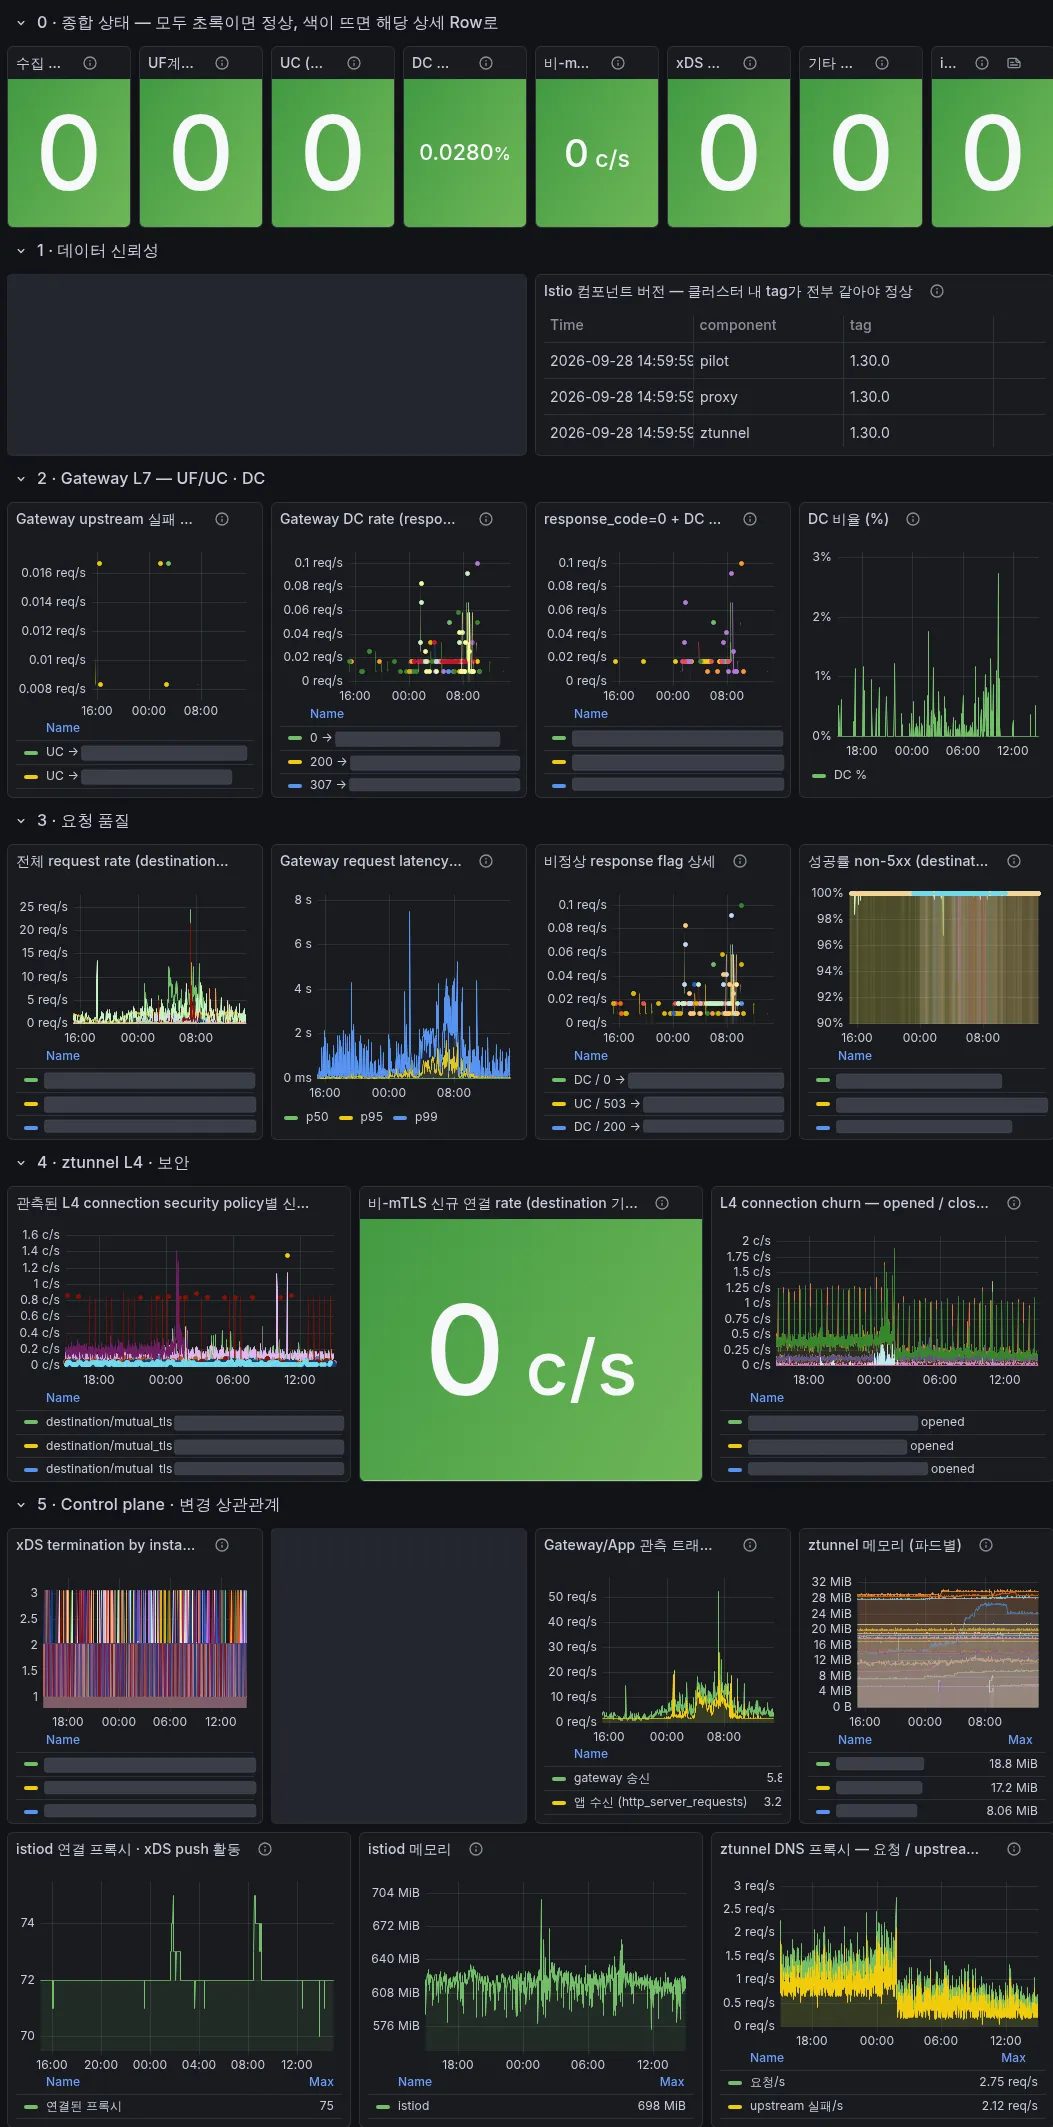
서비스 간 통신을 한눈에 관측하다
서비스마다 access log 구성이 제각각이면, 공통된 기준으로 HTTP 요청을 추적하기가 쉽지 않아요.
Istio를 도입한 뒤에는 외부에서 들어오는 North-South 트래픽이 Istio Gateway를 거치면서, access log를 일관된 방식으로 남길 수 있게 됐어요.
내부 파드 사이의 East-West 통신도 마찬가지예요. 예전에는 네트워크 요청이 실제로 어떻게 오가는지 파악하기 어려웠지만, 이제는 ztunnel이 제공하는 L4 지표로 서비스 간 통신을 관측할 수 있게 됐어요.
마치며 🎬
처음 Istio를 검토한 이유는 클러스터 내부 통신의 보안성과 안정성을 높이기 위해서였습니다. 그런데 실제로 도입하고 운영해 보니, 공통된 방식으로 트래픽을 관측할 수 있는 기반을 마련했다는 점도 큰 변화였어요.
Istio Gateway의 access log에는 User-Agent, 요청 경로, Referer 같은 주요 정보를 일관된 형식으로 남길 수 있어요. 덕분에 일반 사용자의 접근인지, AI Agent·AI 크롤러·봇 같은 자동화된 트래픽인지 빠르게 구분할 수 있습니다.
최근에는 봇과 크롤러 트래픽이 다양해지면서, 비정상적인 요청이나 보안 이슈로 이어질 가능성도 커지고 있어요. 공통된 access log가 있으니 특정 User-Agent나 비정상적인 접근 패턴이 늘어나는 상황을 더 빨리 알아채고, 필요하면 차단이나 트래픽 제어 정책으로 바로 연결할 수 있어요.
인프라의 역할은 서버를 안정적으로 운영하는 데서 끝나지 않는 것 같아요. 서비스를 안전하게 연결하고, 트래픽을 관측하고, 변화하는 접근 패턴과 보안 이슈에 빠르게 대응하는 것. 그리고 그 위에서 개발팀과 비즈니스가 새로운 시도를 이어갈 수 있도록 기반을 먼저 다지는 일까지가 인프라의 몫이라고 생각합니다.
저희는 앞으로도 서비스가 성장하는 속도에 맞춰, 더 안전하고 더 잘 보이고 더 효율적인 인프라를 만들어 갈 거예요.
에이피알에서 저희와 함께 이 여정을 함께할 엔지니어분도 기다리고 있을게요! 😊
감사합니다.


